Генерация важности функций с использованием обучения Scikit и случайного леса
Изучите базовую концепцию использования случайного леса в ваших проектах и сравните результаты различных методов.

Изучите базовую концепцию использования случайного леса в ваших проектах и сравните результаты различных методов.

В этой статье я кратко расскажу вам, как спрогнозировать вариантную цену на основе рассмотрения нескольких переменных, которые могут быть связаны с изменением цены. К концу этой статьи вы сможете прим

Ускорьте предварительную обработку данных с помощью нормального распределения Numpy. Узнайте, как быстро сократить трудоемкие задачи предварительной обработки данных с помощью этого мощного инструмент

В этой статье я расскажу вам, как визуализировать ежедневные цены и объемы тиккерных акций с помощью yFinance, mplfinance и Pandas.

Откройте для себя возможности биномиального распределения Numpy! Узнайте, как этот надежный инструмент помогает точно и быстро анализировать данные и принимать обоснованные решения. Получите максималь
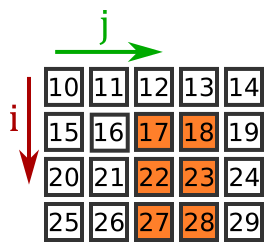
Ускорьте предварительную обработку данных с помощью Numpy Array Slicing. Узнайте, как быстро сократить трудоемкие задачи предварительной обработки данных с помощью этого мощного инструмента. Узнайте,

Представьте Pandas GroupBy() и узнайте, как объединить несколько наборов значений в один набор с общим ключом, узнайте больше.

1 плюс 2 важных этапа предварительной обработки данных с использованием Python, Scikit Learn. Вы можете начать работу над проектом машинного обучения и анализа данных.
В этой статье рассказывается, как преобразовать столбец в строку с помощью Set_index().T, предоставленного Pandas и Python. Изучите и получите скрипт.

Ознакомьтесь с полным руководством по подготовке материалов для машинного обучения строковых типов данных. Или мы вызываем очистку текста для НЛП перед внедрением машинного обучения.

Сводная таблица Pandas() позволяет разработчикам очень эффективно манипулировать данными. Итак, в этой статье рассказывается, как массово переносить данные.